SIGReg e repulsão no treino de JEPA
Publicação de 28 de setembro de 2026 descreve como SIGReg, usado por LeJEPA e LeWM, aproxima um sliced MMD cuja expansão revela repulsão entre pares de amostras no batch.
Ler artigoConhecimento para aplicar
Bookmarks atualizados diariamente: notícias, fatos e descobertas relevantes.
Publicação de 28 de setembro de 2026 descreve como SIGReg, usado por LeJEPA e LeWM, aproxima um sliced MMD cuja expansão revela repulsão entre pares de amostras no batch.
Ler artigoPublicado em 27 de setembro de 2026, o HySparse2 é descrito como um método híbrido de atenção esparsa com compartilhamento de KV em dois níveis, voltado a prefill eficiente e armazenamento compacto de KV cache em agentes com contextos longos e múltiplas interações.
Ler artigoUm artigo da ICLR 2026 trata da inferência autorregressiva eficiente para modelos probabilísticos Transformer e, segundo o post, aborda um gargalo na decodificação.
Ler artigoPublicado em 27 de setembro de 2026, o registro descreve o LENS, um framework de aprendizado por reforço que otimiza raciocínio e segmentação de imagens por texto conjuntamente.
Ler artigoPublicação de 27 de setembro de 2026 relata ablações preliminares que apontam V=K+M como escolha arquitetural eficaz; o resultado ainda precisa de validação em escalas maiores.
Ler artigoUm relato afirma que IPAs do iOS protegidos pelo FairPlay podem ser descriptografados sem iPhone físico ou jailbreak. A alegação pode interessar a quem estuda proteção de apps, mas não é verificada pelo briefing.
Ler artigoTrabalho sobre tracing intra-kernel de GPU por splicing de instruções em nível binário; a prévia destaca probes inseridos nos kernels para registrar dados de execução.
Ler artigoUm artigo apresenta a NSA, mecanismo de atenção esparsa treinável que combina escolhas algorítmicas e otimizações alinhadas ao hardware para modelar contextos longos com mais eficiência.
Ler artigo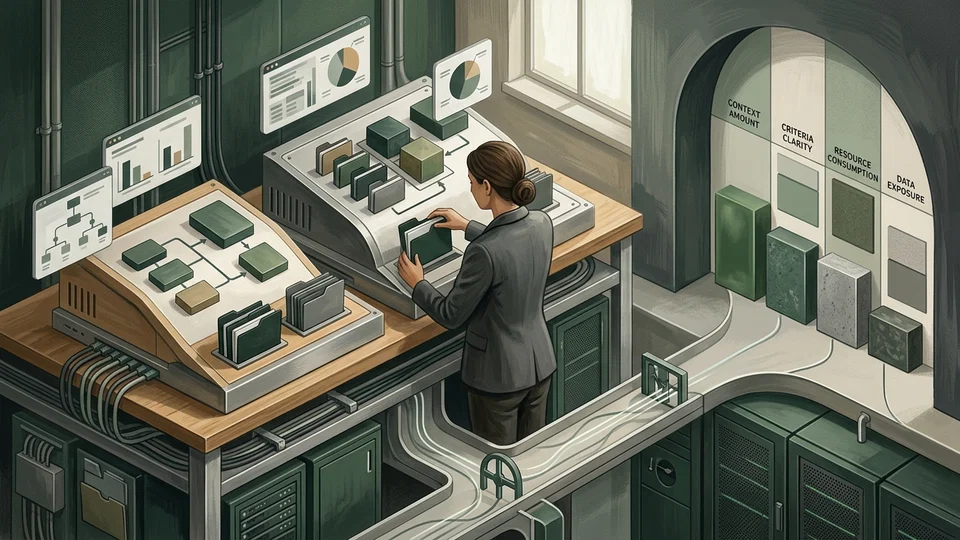
Um fluxo mais elaborado nem sempre melhora o resultado. Compare componentes pela tarefa, pelo consumo e pela exposição de dados.
Ler artigoPublicado em 26 de setembro de 2026, o artigo compara Transformers padrão e Mixture-of-Experts, com e sem looping. Segundo os autores, Looped-MoE escala melhor que a baseline padrão; modelos com looping denso, não.
Ler artigoArtigo publicado em 26 de setembro de 2026 acompanha uma requisição no vLLM, da fila à decodificação, e explica o agendamento por iteração e a alocação de blocos de KV cache.
Ler artigo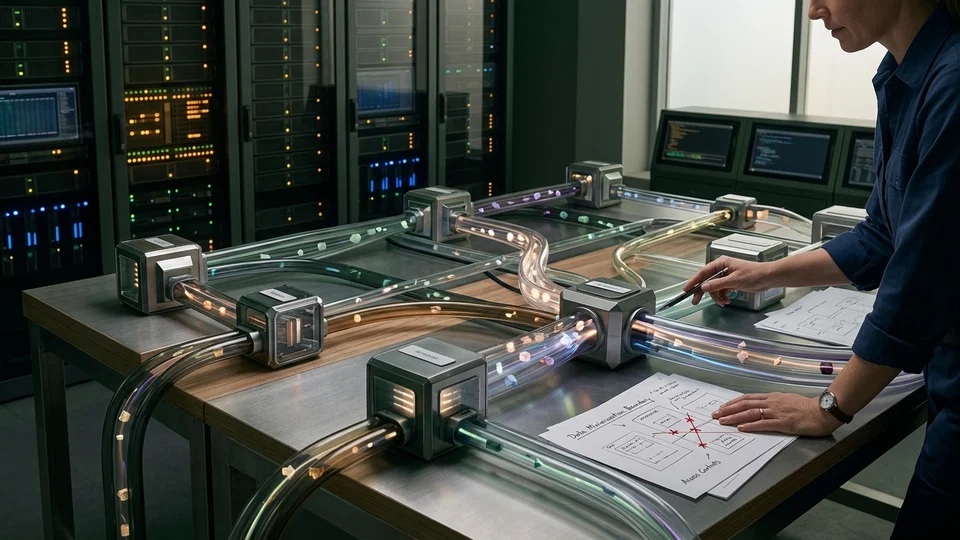
Trocar representações internas não torna a informação anônima. Defina a fronteira de dados antes de ligar vários modelos.
Ler artigoPublicado em 26 de setembro de 2026, o guia da Unsloth vai do nível iniciante ao avançado e apresenta o uso de GRPO no treinamento de modelos de raciocínio.
Ler artigoPublicada em 26 de setembro de 2026, a nota apresenta o JAZ, um framework que usa uma única primitiva recursiva de código para loops de agentes, e relata uma alegação de menor custo e desempenho superior a duas alternativas.
Ler artigoMenos componentes podem facilitar a manutenção. O limite de dados e ações precisa continuar explícito em cada etapa.
Ler artigoPublicado em 26 de setembro de 2026, o trabalho apresenta um critério teórico para a spikiness de feature maps e um feature map com consciência de polaridade por canal. A avaliação considera seis famílias de tarefas visuais.
Ler artigoUm estudo usa sequências de bytes geradas por programas e um gerador adaptativo para investigar se sistemas podem aprender estruturas transferíveis sem treinar com dados naturais.
Ler artigoPublicado em 26 de setembro de 2026, o artigo apresenta um método de compressão de LLMs com decomposição em valores singulares (SVD) que atualiza os pesos comprimidos após o truncamento.
Ler artigoArtigo relata três formas de redundância computacional entre loops em Transformers com loops. Segundo os autores, explorá-las reduz a latência em 1,65× e o uso de memória em 6×.
Ler artigoPublicado em 26 de setembro de 2026, o resumo relata que o Transformer-Within-Transformer substitui grupos contíguos de camadas semelhantes por camadas substitutas com attention. Em DINOv2, a abordagem teria usado cerca de metade do compute, com pequena queda de acurácia.
Ler artigoRota Nacional
30 dias, sem cartão, com quota inicial. Depois, crédito por Pix a partir de R$ 10,00.